


Авторы статьи: Константин Хохрин и Анатолий Коротков, основатели Адаптивной стратегии. Мы проводим обучение и внедрение ИИ в процессы компании, сопровождая до получения фин.эффекта.
Зачем нужен чек-лист ИИ диагностики
В августовской статье про вопросы к стратсессии мы обсуждали какую дополнительную ценность можно создать с помощью ИИ, а эта статья написана для оценки настоящего: что у нас фактически есть сегодня. Она дает диагностический инструмент в виде чек-листа, чтобы оценить точку А.
Чек-лист позволяет оценить дает ли ИИ фин.эффект, ускоряет ли маховик решений, насколько гибкая архитектура. Это первостепенные вещи, когда компания идет в ИИ трансформацию. Они определяют, сможете ли вы перейти на следующий уровень на уровне компании, а второстепенные вещи (типа количества внедрений, частоты использования нейросети, количества обученных сотрудников, показанных на комитете демо) хорошо смотрятся в презентации, являются метриками действия, не гарантируя результата.
Как устроен чек-лист:
- Уровень определяется по 7 вопросам
- В модель заложено 4 уровня: “Стихийный уровень”, “AI-Enabled”, “AI-First”, “AI-Native” (смотрите статью про уровни зрелости, поясняющую, зачем компании стремиться к переходу на следующий уровень)
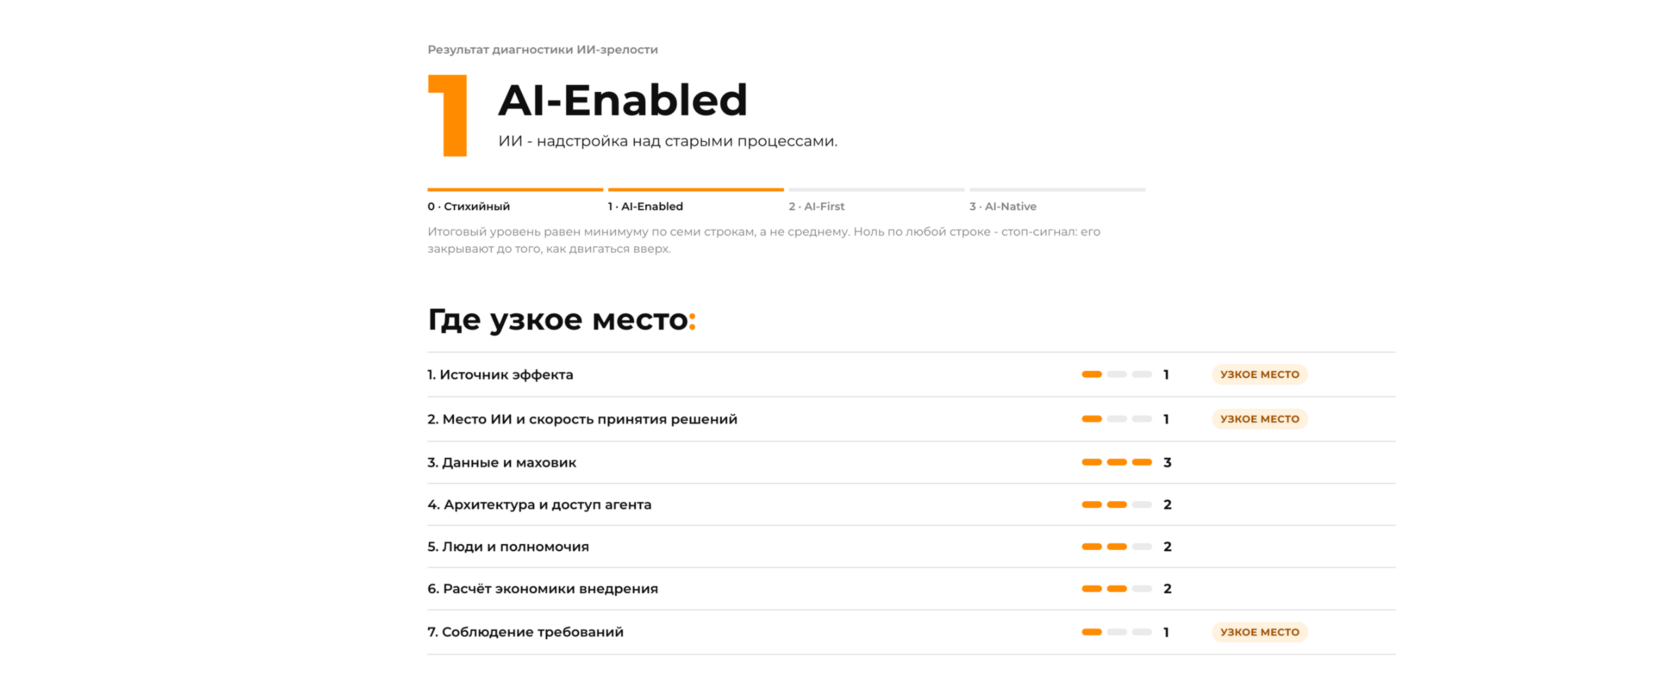
- Уровень считается по слабейшему звену, а не по среднему. Компания не бывает AI-First в среднем. Вспоминаем Элияху Голдратта, который говорил, что компания продает продуктивность своего самого узкого места.
Чего нет в этой статье: оценки людей, требований к ролям, механики перестройки процесса. На эту тему будут отдельные статьи серии, анонсы выйдут в телеграмм-канале Адаптивная стратегия.
Предостережение: почему самостоятельная оценка ИИ зрелости может быть обманчива
Кейс из жизни. Мы работали с собственником ИТ компании, в которой было семь продуктов. На подготовке к стратсессии он утверждал (и судя по словам и невербалике, был абсолютно в этом уверен): “Мы отлично понимаем текущие и будущие потребности своих клиентов, весь портфель из семи продуктов построен вокруг них”.
Тогда мы попросили проверить это статистикой продаж и воронкой. Выяснилось, что реально продавались только два продукта из семи. Остальные пять существовали в презентациях и на сайте, но не у клиентов. Понимание потребностей так и осталось мнением, даже предварительным интересом от клиентов (запросами в начале воронки) мнение не подтвердилось.
При этом никто не врал. Он искренне описывал то, во что верил, и как визионер у него в голове это был почти свершившийся факт.
Что сделали потом: запустили трёхмесячное исследование клиентов в формате акселератора. В итоге: четыре продукта из пяти закрыли, появились два новых, на этот раз действительно на основе потребностей рынка. После чего встроили исследование в регулярные процессы компании.
Тот же разрыв мы видим в оценках ИИ-зрелости. Но если там была воронка продаж, через которую можно было проверить мнение, то для ИИ-зрелости такого готового отчёта не существует. Чтобы были твердые факты, на которые можно опираться, мы и сделали этот чек-лист.
Три причины, которые могут давать ложный результат:
- Ответы ложатся в оценку без доказательств
- Компания считает метрики действия вместо метрик реального результата
- Оценки усредняются по компании
Поэтому мы вывели два основных правила чек-листа:
- Если на вопрос нельзя ответить, назвав ценностную метрику, документ или фамилию, значит ответ "нет".
- Уровень компании равен минимуму по измерениям, а не среднему.
Зачем изобретать велосипед
Готовых моделей зрелости десятки, мы изучили основные. Проблема в том, что почти все они устроены одинаково неудобно для собственника и не учитывают российскую специфику. Неудобно - потому что меряют наличие чего-либо: есть ли стратегия, есть ли пайплайн данных, есть ли governance. Всё есть, а что изменилось в компании - непонятно. В своей модели мы оцениваем и действия, и что это дало. Главная задача чеклиста - найти, как шагнуть на следующий уровень, который приносит больше маржи.
Вторая проблема существующих моделей оценки в том, что они не учитывают российскую специфику - потому что в западных моделях нет ни 152-ФЗ, ни локализации данных, ни необходимости уметь быстро менять модель между Яндексом, Сбером и устанавливаемыми в контуре компании моделями. А в России возможность сменить модель обязательно надо закладывать на стадии пилотирования, чтобы архитектура была гибкая. Доступ может закрыться, требования по локализации могут поменяться. По нашему опыту проверку первых пилотов быстрее всего провести на инструментах OpenAI (Codex, ChatGPT) или Anthropic (Claude, Code), а на масштабировании локализовать на российских или открытых инструментах. Но делать это стоит через собственный шлюз с обезличиванием данных и логированием.
Рамка уровней
Чек-лист построен на трехуровневой модели, которую описывает майская статья.
В ней определены три уровня:
1. AI-Enabled: на этом уровне ИИ - это надстройка над старыми процессами.
2. AI-First: ключевые бизнес-процессы перепроектированы с учётом возможностей ИИ.
3. AI-Native: бизнес-модель пересобрана с учётом ИИ. Технология позволяет создавать новые источники маржи, а не только экономить. Без ИИ компания на этом уровне не сможет произвести или продать продукт/услугу по той же цене.
В дополнение к этой модели мы в чек-лист встроили еще один уровень: Нулевой "Стихийный" уровень. Это не отсутствие ИИ (его все уже используют мало-помалу), это ИИ без контроля. Пока топ-менеджмент считает, что у него не внедрен ИИ, сотрудники уже загружают договоры и клиентские данные в личные аккаунты ChatGPT / Deepseek / Claude. Формально вы на нуле. Фактически ИИ-контур у вас уже есть, просто вы им не управляете и не знаете, где лежат ваши данные.
Признаки нулевого уровня:
- тема ИИ обсуждается в курилке как риск увольнений или как хайп, но не как строка в бюджете
- нет человека, отвечающего за внедрение ИИ
- активное теневое использование снизу: люди решают рабочие задачи в личных аккаунтах, генеральный директор только догадывается, чем пользуются сотрудники
- никто не может ответить, какие данные компании уже ушли во внешние модели
Ноль по любому измерению - это открытая дыра. Ноль работает как стоп-сигнал: его закрывают до того, как начинают двигаться вверх по уровням.
Начинать со стратегии на нулевом уровне бессмысленно. Сначала - инвентаризация: какие инструменты уже используются, кем, с какими данными. Это первое, что мы делаем на диагностике, и почти всегда самое неприятное для собственника/генерального директора открытие.
В западных моделях зрелости теневой ИИ - это вопрос дисциплины. Компания покупает корпоративные лицензии, получает договор, гарантию необучения на своих данных, единый вход и логи. Теневое использование закрывается административно.
В России этого варианта нет, т.к. корпоративного контракта с фронтир-вендорами не может быть, а значит нет ни гарантий, ни логов. Сотрудник, которому нужна сильная модель, идёт в личный аккаунт, потому что другого способа не предусмотрено. Есть обходной маневр в том, чтобы купить доступ к передовым моделям через посредников, но стабильность этого решения пока оставляет желать лучшего.
Отсюда разница, которую не видно из западных фреймворков. Теневой ИИ у нас - это особенность архитектуры, и запретом или обучением он не лечится. Запрет не создаёт способа работать, а обучение только увеличит число людей, которые пойдут в личный аккаунт. Лечится он гибкой архитектурой.
Чек-лист оценки и индекс зрелости
В статье описана логика чек-листа, а чтобы им воспользоваться, перейдите по ссылке https://ai.adaptivestrategy.ru/ai-maturity/
Два термина в таблице требуют пояснения, оба разберём подробно после неё.
Маховик данных - когда работа с ИИ оставляет след, из которого система становится лучше: логи, пометки людей о качестве, регулярные проверки. Говоря проще, это петля непрерывного самоулучшения.
Гибкая архитектура - когда системы компании собраны из сменных блоков с описанными стыками: агент может в них легко попасть, модель можно заменить, не переписывая процессы.
Первый ИИ-двигатель трансформации: маховик данных
Маховик - это когда работа оставляет след, из которого система становится лучше. При этом объем данных не так важен. Компания может иметь Big data и нулевой маховик, не используя данные, которые копила годами.
Если маховик работает, то ваши данные и построенная вокруг них головами ваших людей петля обратной связи - это и есть конкурентное преимущество. Сами модели LLM скоро станут как электричество, доступное всем.
Самый главный сигнал качества - это правка человека. Каждый раз, когда сотрудник переписывает вывод модели, он делает разметку. Если суть правки не сохраняется, вы выбрасываете актив.
Что нужно для запуска маховика:
- Логировать запрос и ответ с версией промта
- Сохранять правки человека и подавать их на вход модели для обучения
- Иметь эталонный набор данных, на которых можно проверить каждую следующую версию системы (называется eval, русского единого термина пока не придумали)
- Закрепить владельца этого цикла и частоту обновления
Ключевая метрика маховика - это время от "заметили ошибку" до "исправление реализовано".
На какие типовые грабли не надо наступать:
- Запускать маховик без владельца
- Собирать данные на будущее без гипотезы
- Проводить опросы вместо сбора данных с реального процесса
- Проводить обучение только на успешных кейсах: нейронка, как и человек, хорошо учится на ошибках
Пример на себе:
Продукт Адаптивный фокус вырос из внутренней потребности: проводя более 100 стратегических сессий в год, мы накапливали инструменты, методологию и данные. С приходом ИИ появилась возможность упаковать это в систему агентов и открыть клиентам.
Один из агентов, Эван, занимается разведкой рынка, конкурентов, отраслевых трендов, технологических сдвигов, регуляторных изменений и географических особенностей. Поставляет угрозы и возможности, которые команда не всегда видит изнутри.
Эван готовит стратегический бриф для клиента, потом мы его вычитываем и делаем разметку: это факт или гипотеза. Далее он обогащается в отдельных полях комментариями стратега Адаптива, и далее комментариями топ-менеджеров клиента.
Важный момент: эта разметка структурная, а не правки в тексте. Сделано для того, чтобы правка в отдельном поле могла улучшать все следующие. Ровно тут проходит граница между ручным улучшением и маховиком.
Комментарий показывает, что именно делать: докручивать промпт, менять источники, расширять поиск. Без комментариев нейронка правдоподобную догадку подаёт ровно с той же уверенностью, что и проверенный факт. Эту разметку могут поставить только люди, которые одновременно знают методологию, отрасль клиента, инсайдерскую информацию.
Практический совет: подумайте, что вы как человек будете размечать в выводе модели, чтобы улучшать качество ее работы непрерывно. Ответ должен быть не просто оценкой по пятибалльной шкале, так как такой вариант не дает предметной обратной связи.
Второй двигатель: гибкая архитектура
Ситуация: проектно-торговая компания, маржа медленно падает четвёртый квартал подряд. Узкое место - поиск и проектирование: тридцать человек, переделки, пересогласования, потери хороших проектов.
Этот участок мы пересобрали на ИИ за четыре месяца, разработав агента-снабженца. Он ведёт закупку от заявки до сделки. Чтобы это делать, он ходит в четыре внешних контура: закрытые закупочные площадки, CRM, Контур.Фокус и Интерфакс. Площадки дают предложения, CRM - историю и следующее действие, Фокус и Интерфакс - проверку контрагента.
Последовательность улучшений: сначала точность проектируемой маржи (выросла с 70 до 90 процентов), потом расширенный поиск проектов, потом автономный процесс с точками принятия решений, и в конце отладка с проверками качества (evals). В сухом остатке: квартальная выручка компании удвоилась.
Самое интересное началось на пятом месяце. ИИ нашёл крупный проект, на который компания раньше не смотрела: вход туда закрывала сложная сертификация партнёрского предприятия. Обычный путь к такой сертификации - это проект на 12 месяцев, 20 человек и десятки миллионов рублей. Компания этот путь не рассматривала никогда, так как экономика не сходилась.
Второй участок собрали по образцу первого. Агенты разобрали блокер на требования, документы и доказательства и предложили способ проверить гипотезу. Работали в проекте 2 человека и через 2 недели получили сертификацию. Проекты, которые после этого стали доступны, примерно в 50 раз крупнее прежних.
Стоимость попытки
12 месяцев против 14 дней, 20 человек против двух - вот что здесь стоит сравнивать.
За 5 месяцев компания научилась сильно дешевле проверять гипотезы. Пока такая проверка стоит 12 месяцев, до выбора между вариантами дело не доходит.
Суть гибкой архитектуры в том, что каждый следующий участок обходится дешевле предыдущего. Важно: участок здесь не равен отделу, границу определяют по ценному результату: где начинается и где заканчивается то, за что платит клиент. Такие участки в ИИ-трансформации называются доменами. Как правильно выбирать домены, разберем детальнее в одной из следующих статей.
Проверяется стоимость попытки вопросом: во что вам обошёлся второй ИИ-проект по сравнению с первым? Если примерно в то же самое, значит вы пока что делаете серию отдельных проектов. Пора задуматься об архитектуре.
Что делает следующий участок дешевле
Переиспользование агентов, помощников и проверок качества с версиями, владельцем и правами доступа. Это нужно, чтобы решения из одного участка становились стартовой точкой для следующего. 14 дней во втором участке получились именно поэтому: его собирали не с нуля, а по образцу первого.
Правило выбора модели. Не одна лучшая модель на всё, а понятное правило, какая модель на какой задаче и на каком классе данных. Критерии - качество, стоимость и чувствительность данных. Последний критерий в России оказывается решающим: часть задач по определению не уходит наружу, поэтому в контуре одновременно живут минимум две модели, локальная и внешняя.
Это же закрывает вопрос про нулевой уровень. Теневое использование не лечится запретом, потому что запрет не дает способа работать. А выбор модели (что идет во внутреннюю, что во внешнюю) дает возможность работать. И заодно смена вендора перестаёт быть катастрофой - если доступ закроется завтра, это должно означать правку настроек, а не остановку процессов.
Также важный вопрос, влияющий на экономику, - как именно агента подключают к системе. До недавнего времени каждая пара "агент - система" была отдельной разработкой: 5 агентов и 7 систем давали 35 интеграций. Сейчас складывается стандарт MCP (Model Context Protocol), который превращает это в розетку: система один раз описывает, что она умеет, и дальше к ней подключается любой агент. Просите подрядчика сделать так, чтобы к системе мог легко подключиться следующий агент.
Права агента
Когда агент начинает действовать сам, появляется вопрос, которого в прежней ИТ-архитектуре не было: кто принял решение.
Модель может предложить действие, человек со своими правами доступа подтверждает действие, это сохраняется в журнал. Инструкция в промпте не работает как ограничение - модель может ей не последовать, и никакого механизма, который бы это предотвратил, в самой модели нет.
Три вопроса для проверки гибкости архитектуры:
- Во сколько обошёлся ваш второй ИИ-проект по сравнению с первым?
- Сколько источников участвует в одном решении и сколько занимает подключение каждого?
- Что произойдёт, если доступ к вашей модели закроется завтра?
Как воспользоваться чек-листом
Откройте чек-лист по ссылке https://ai.adaptivestrategy.ru/ai-maturity/
- По каждому вопросу выберите уровень, который описывает вас сегодня, а не то, к чему вы идёте.
- Заполните поле "Где это видно". Для уровней 1…3 поле обязательно.
- Посмотрите на минимум, а не на среднее. Уровень ИИ-зрелости определяется самой низкой оценкой.
- Если где-то ноль, то это стоп-сигнал. Начинать надо с него.
- Изучите лист с результатом и рекомендациями.
- Скопируйте себе ссылку на результаты, чтобы поделиться с командой или с нами.
Частые варианты результатов
Помогая российскому бизнесу с оптимизацией процессов с помощью ИИ, мы встречаем сейчас такие типовые варианты:
- Теневой ИИ: ноль по строкам 5 “Люди и полномочия” или 7 “Соблюдение требований”, у вас неуправляемый ИИ. Первое действие - это инвентаризация, шлюз между разными моделями, политика: какие данные куда можно отправлять. А потом уже стратегия.
- Кладбище пилотов: единицы почти везде, много запусков, ничего не масштабируется. Основная причина в стоимости интеграции.
- Остров эффективности: двойки или тройки по строкам 1 и 2, единицы по строкам 3 и 4, потому что маховик и гибкая архитектура не построены.
- Готовы к рывку (двойки почти везде, нулей нет): узкое место одно, которое надо расширить.
Что дает самодиагностика, а что нет
Что самодиагностика даёт: уровень и слабейшее звено. Этого достаточно, чтобы понять, где вы сейчас, и провести разговор в топ-команде без лишних споров.
Чего она не даёт. Первое - проверку ответов: правило доказательства работает, только когда доказательства смотрят со стороны, внутри команды их часто смягчают.
Второе - деньги: чек-лист не считает ROI и не говорит, какой процесс брать первым по экономике.
Третье - карту: разрыв с конкурентами и приоритеты по срокам из таблицы не выводятся.
Если после заполнения нужна дорожная карта ИИ-трансформации и помощь во внедрении, то у нас она называется Адаптивный ИИ-скан: два дня, фиксированный бюджет. Проверяем ответы на доказательствах, инвентаризируем теневое использование, выбираем первый домен для трансформации, считаем ROI по нему, сканируем конкурентов и собираем дорожную карту.
Заполненный чек-лист сокращает подготовку - приходите с ним в Телеграм @Hello_Adaptive
План перехода на следующий уровень
Что учитывать при планировании перехода:
- Один уровень за раз. Прыжки через уровень невозможны.
- Один процесс-локомотив вместо портфеля из 5 пилотов. Критерии выбора: частота, объём, цифровой след, терпимость к ошибке, наличие владельца системы, наличие спонсора на уровне не ниже ГД-1, считаемый эффект.
- Сначала пересматриваем процесс, потом накладываем ИИ.
- Грубый план на квартал: первые 30 дней - снять текущие метрики процесса, следующие 30 дней - пересборка процесса и запуск маховика, еще 30 дней - evals, уточнение экономики, решение масштабировать или закрыть.
- Что решено до старта плана: назван человек, отвечающий за результат (не за проект, а за то, работает ли система в операционке).
- Критерий, что переход состоялся: изменилось одно из четырёх - где принимается решение, кто его принимает, скорость цикла, структура маржи. Помним, что количество внедрений - не ключевой показатель.
Заключение
Заполняйте чек-лист, присылайте в Телеграм @Hello_Adaptive.
Скоро в этой серии статей выйдут статьи про перестройку процесса, требования к ролям и культуру, подписывайтесь на наш телеграмм канал Адаптивная стратегия, чтобы получить их.
Полезные статьи: